Jul 29, 2026·面试-八股·6 min
每日面试一问/Mysql篇-04
讲一下mysql innodb的索引结构? 为什么用b+树不用b树? 聚簇索引和非聚簇索引的区别?回表查询是一定会执行的吗?
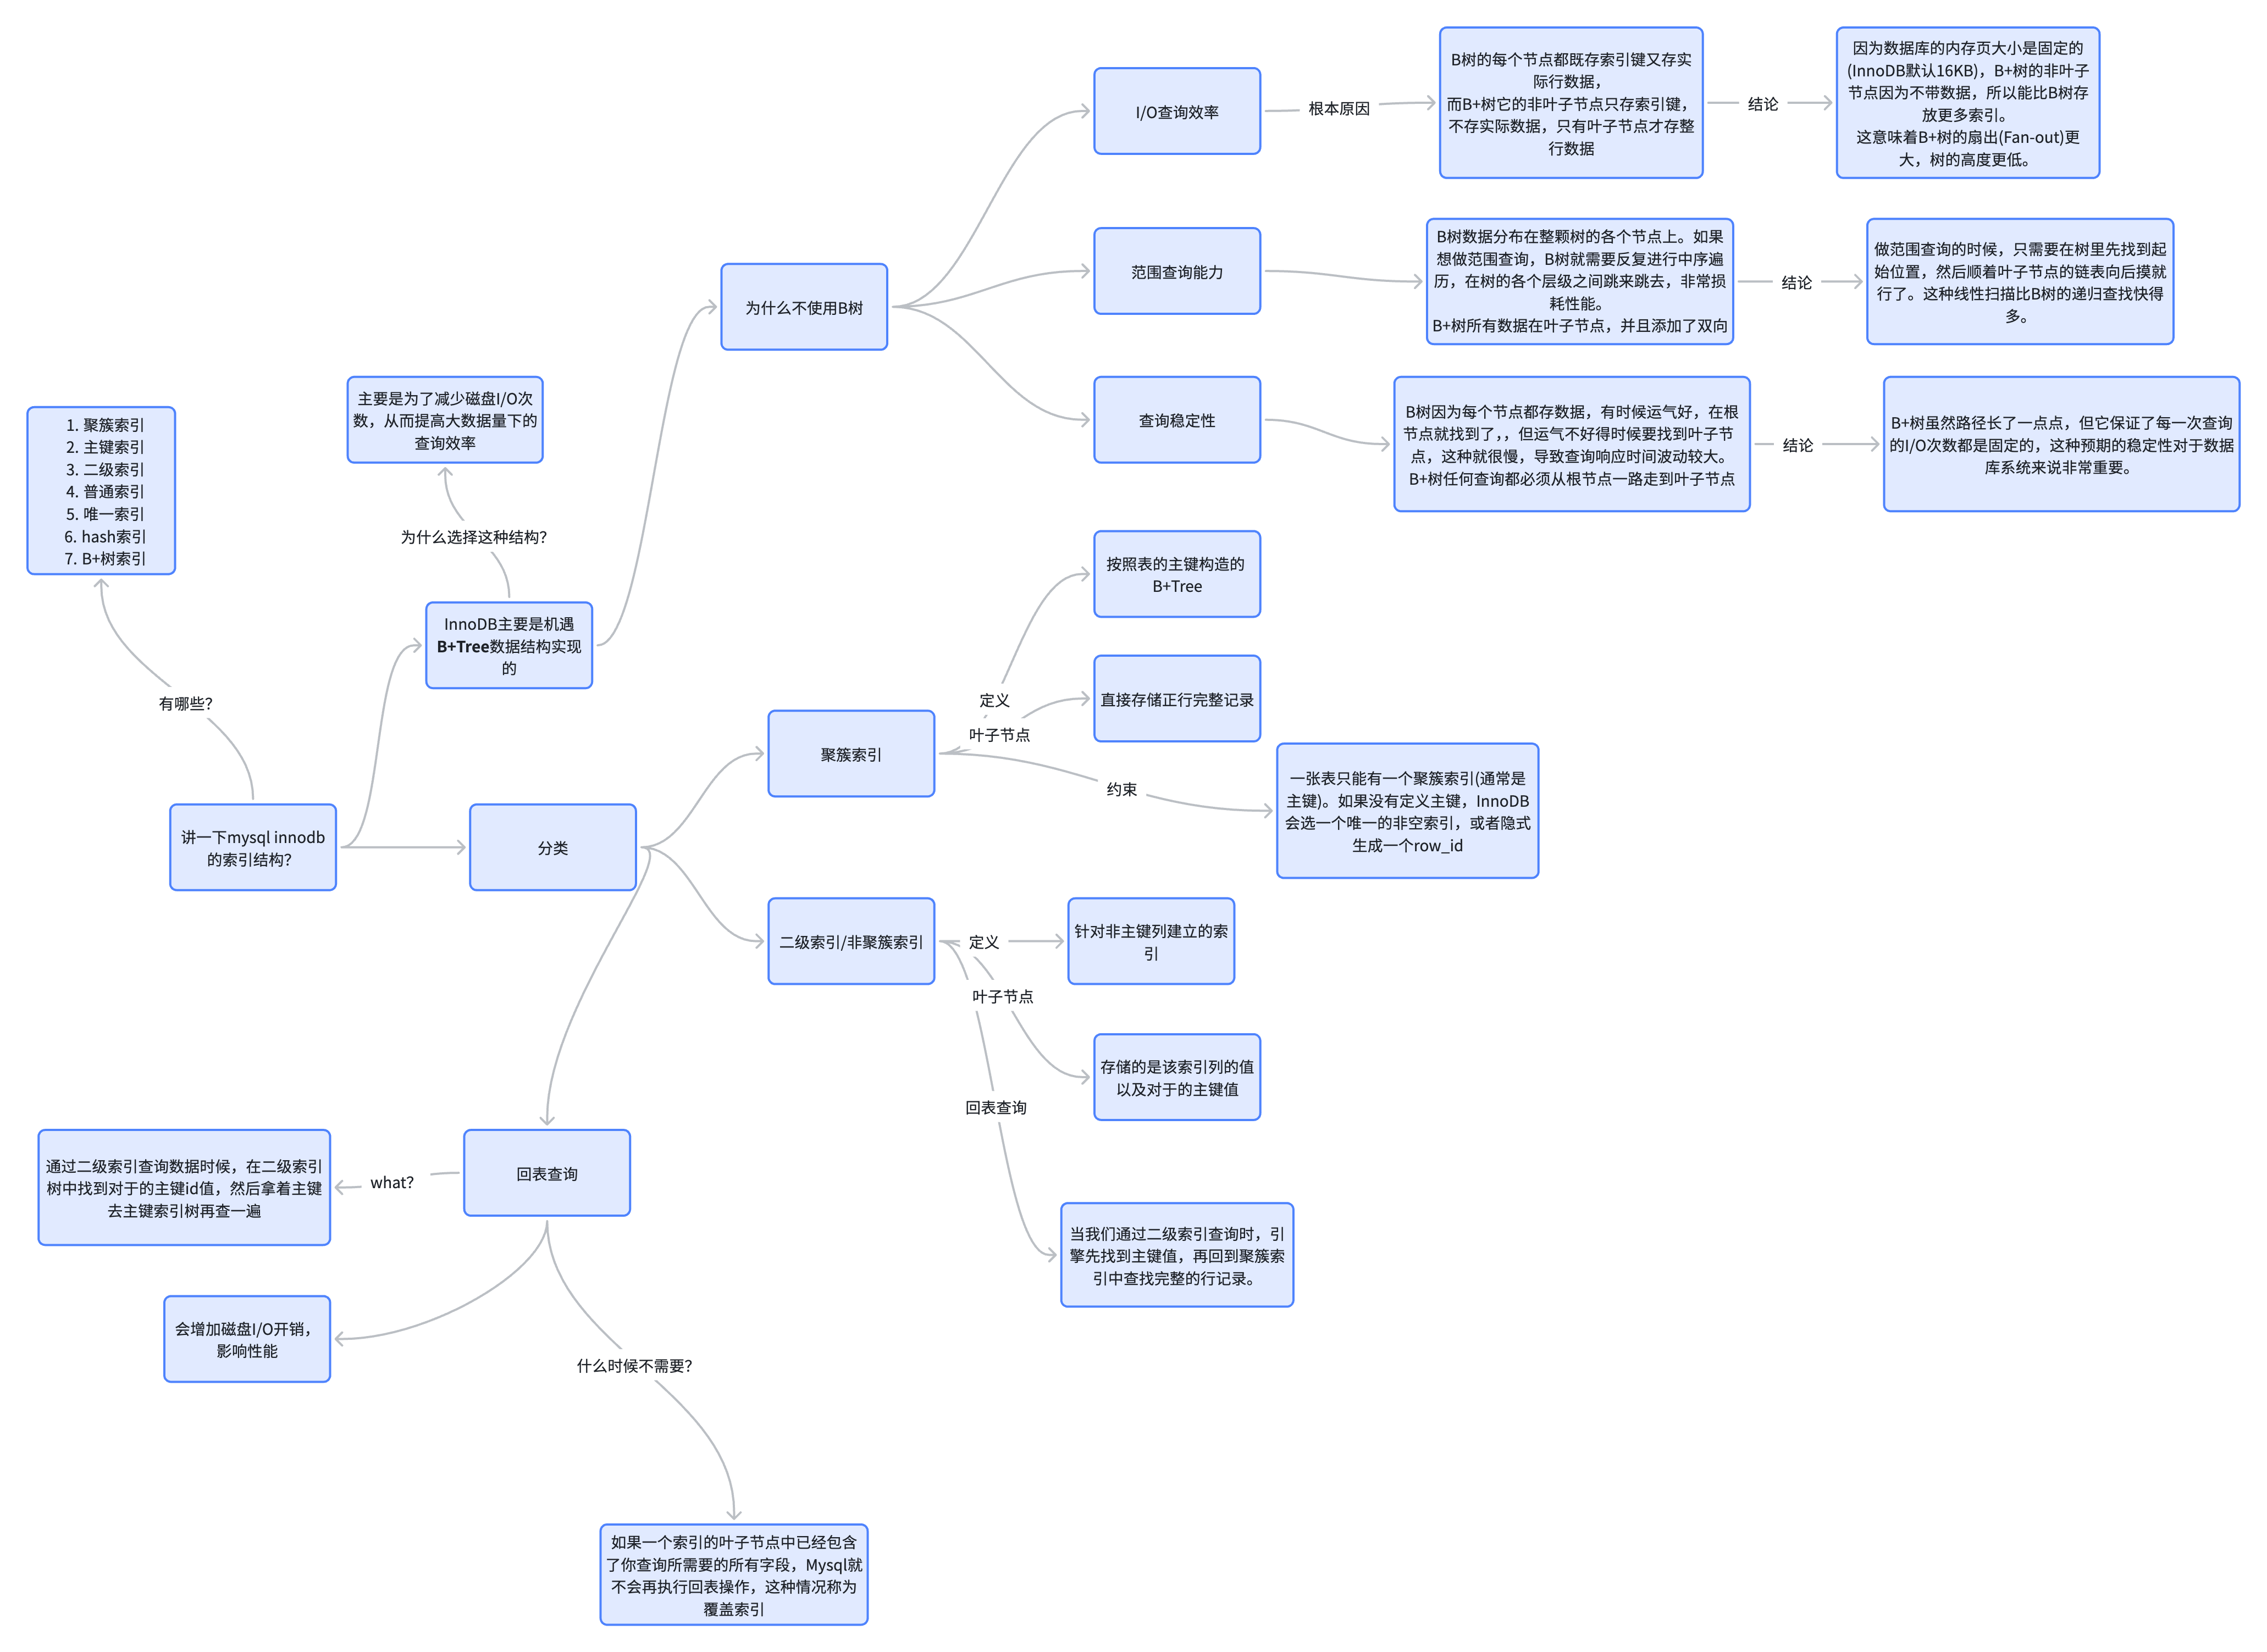
讲一下MySQL InnoDB的索引结构#
InnoDB 的索引结构,简单来说,它就像一个字典的目录。底层的核心实现是 B+Tree。
B+Tree的非叶子节点#
那么为什么为什么选择 B+Tree呢?B+Tree的非叶子节点存储的不是实际的数据,而存储的是索引键,因为不存储数据,所以这一页里面能存储很多索引,这也就使得整个B+Tree变得“矮胖”。哪怕是千万级别的数据,树通常也就是 3-4层。这意味着我们找一条数据最后只需要 3-4次的磁盘I/O,速度非常快。
B+Tree的叶子节点#
B+Tree的叶子节点才是真正存储数据的地方,而且 B+Tree 树将所有的叶子节点用一个双向链表串起来了。这样我们在做范围查询的时候,只需要找到起始值,然后顺着链表往后摸就行了,效率极高。
索引分类#
在分类上,分成:聚簇索引和二级索引,也叫非聚簇索引。
聚簇索引的叶子节点直接存放的是整行的完整数据,而二级索引的叶子节点则存储的是索引列的值与对应的主键ID。
当通过二级索引查询非索引涵盖的字段的时候,系统会先获取主键ID,再通过主键ID检索聚簇索引,这个过程称为回表。
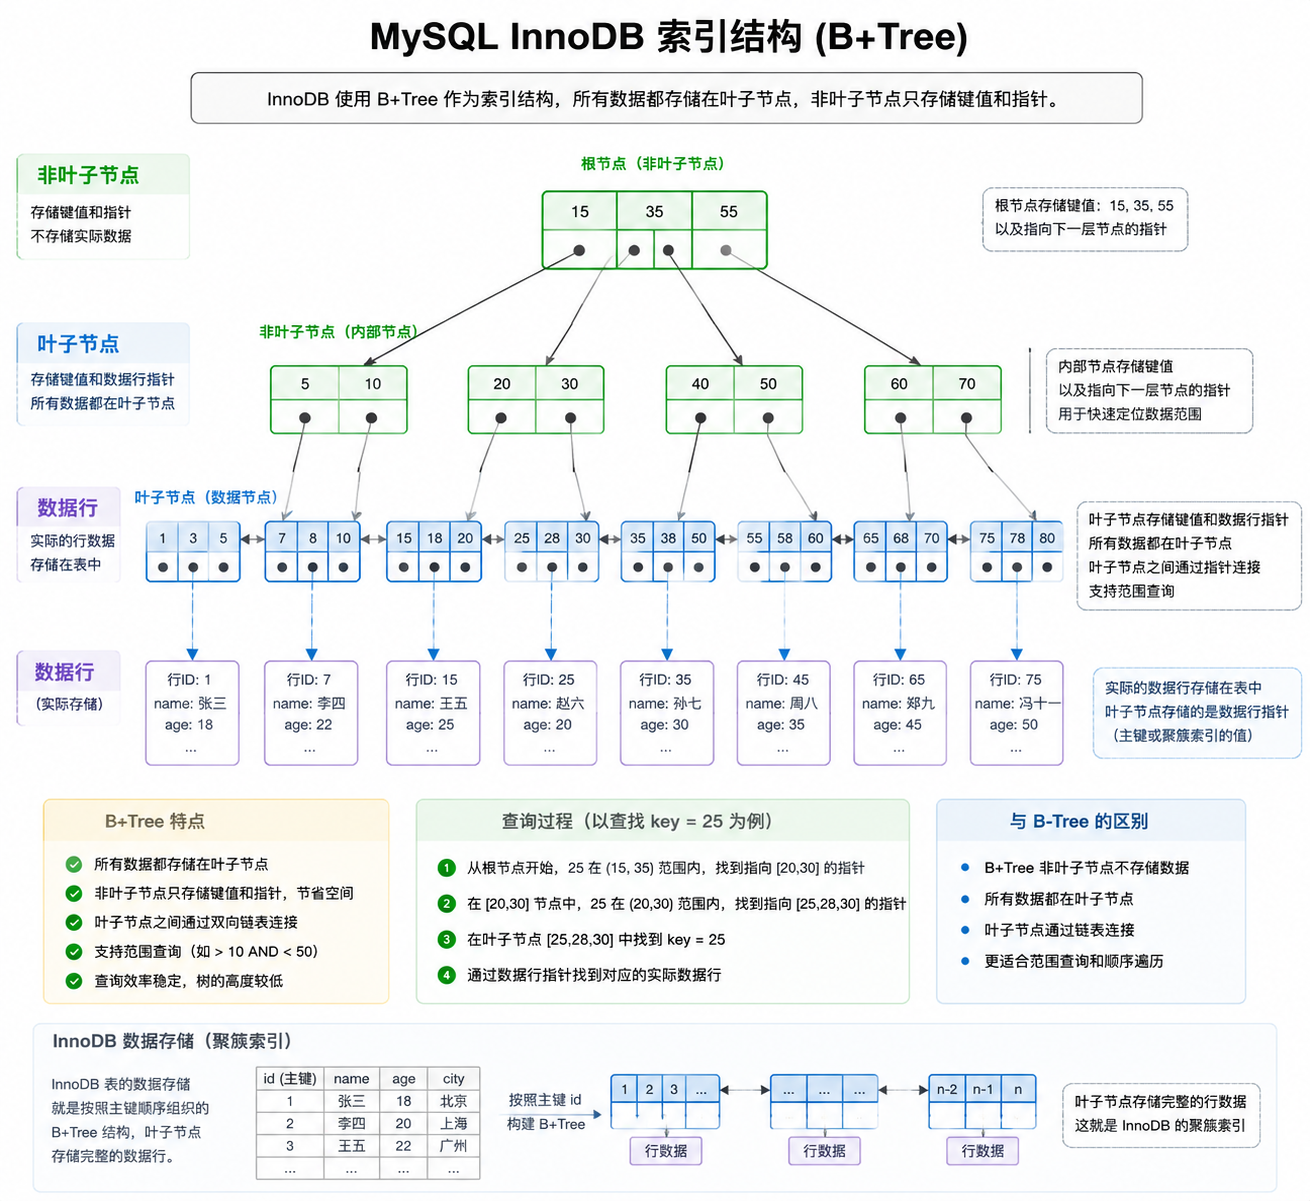
为什么用 B+ 树 不用 B树?#
主要是基于I/O效率、范围查询能力和查询稳定性这三个核心优势。
I/O效率#
首先,B+Tree非叶子节点只存储索引键而为不存储实际行数据,这使得单个内存页能容纳更多的指针,树的结构变得更加“矮胖”,即使千万级数据也只需要 3-4次的磁盘I/O即可定位目标。
范围查询能力#
其次,B+Tree的所有数据集中在叶子节点上,并且叶子节点直接通过双向链表相连,在处理数据高频的范围查或排序的时候,只需要在线性链表上进行扫描,而B树则需要频繁的在不同层级间进行中序遍历,效率低。
查询稳定性#
最后B+Tree保证了任何查询都必须从根节点走到叶子节点,这使得查询的磁盘I/O次数是恒定的,提供了更稳定的响应时间。
简单来说,B+Tree通过牺牲了非叶子节点的数据存储,换取了更低的树高度和更强的范围扫描能力。
聚簇索引和非聚簇索引的区别?回表查询是一定会执行的吗?#
聚簇索引和非聚簇索引的核心区别子在于叶子节点存放的内容不同。
聚簇索引#
聚簇索引的叶子及诶单直接存放完整的行记录。
非聚簇索引#
而非聚簇索引存放索引列值和主键ID。
回表查询、覆盖索引#
因此,回表查询非必须执行,如果我们查询的字段已经全部包含在当前的二级索引中,也就是覆盖索引,MySQL就可以直接在二级索引树上获取数据并返回,从而跳过回表操作,大幅度减少磁盘I/O提升性能。
© 2026 可梵 · CC BY-NC-SA 4.0 许可
读者见解 / Discussions
0加载讨论中...